La nueva IA de Microsoft da miedo: puede replicar cualquier voz con solo 3 segundos de audio
La compañía norteamericana presenta en sociedad a VALL-E.

No cabe ninguna duda ya. La inteligencia artificial era un concepto que sonaba chulo hace unas décadas y que se mencionaba de vez en cuando en alguna que otra película de ciencia ficción y que ha pasado a convertirse en la piedra angular de la tecnología de vanguardia.
Ya te hemos hablado de los 5 mejores cursos gratis para aprender sobre IA, con los que podrás entender mejor un software que permite locuras como la que te mostraremos a continuación, con un modelo capaz de replicar voces humanas de manera sorprendente.
Voces artificiales creadas a partir de pequeñas muestras reales: así es VALL-E
Microsoft, al igual que el resto de empresas del sector, cuenta con departamentos creados para investigar tecnologías que podrían resultar fundamentales en el futuro. En este caso, a través de un estudio publicado en la revista especializada Arxiv, hemos conocido el proyecto denominado VALL-E, que en realidad es un modelo de inteligencia artificial para generar voz a partir de texto, y que permitirá a quien lo utilice poder simular la voz de cualquier persona, simplemente con un audio de muestra de 3 segundos. A partir de ese momento, se podrá replicar cualquier frase con la voz de dicha persona y con el tono elegido, buscando copiar, por tanto, las emociones humanas.
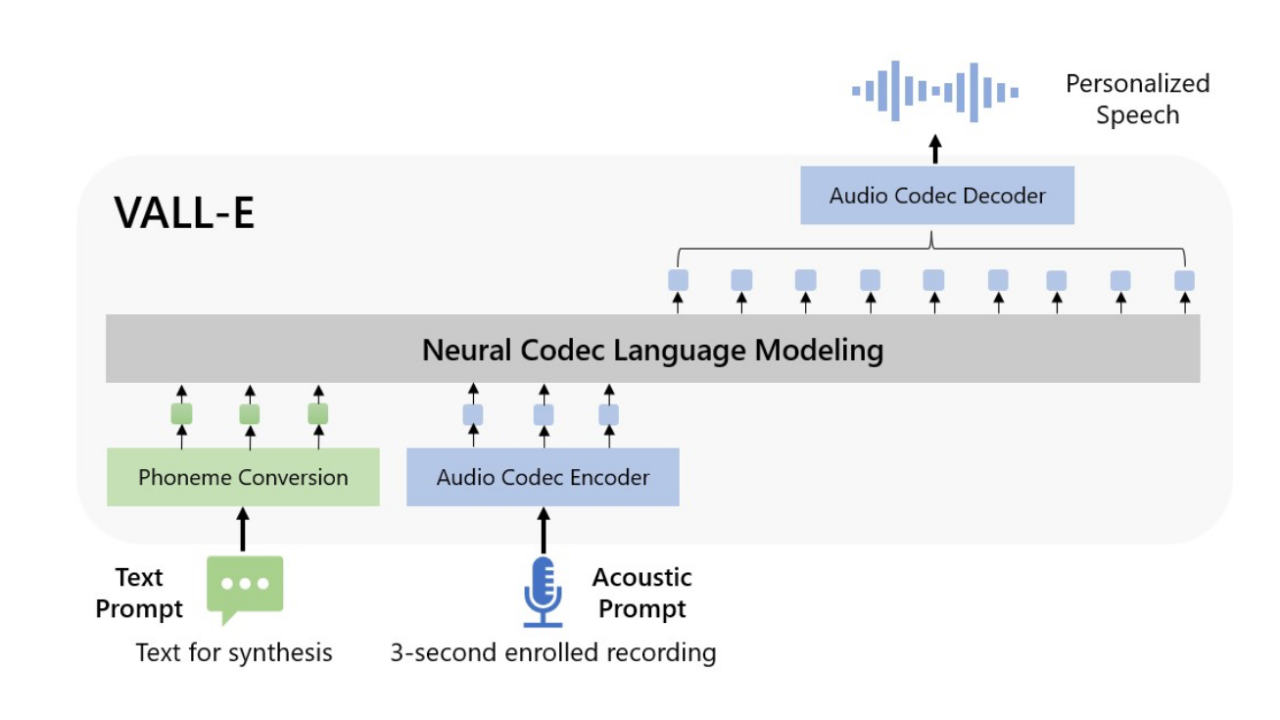
Gráfico con el que Microsoft explica su modelo de voz digital VALL-E. GitHub
Los responsables del proyecto aseguran que VALL-E es un modelo de lenguaje de código neuronal y que ha sido construido a partir de la tecnología EnCodec. En este caso, este sintetizador de voz no sólo manipula ondas de sonido, sino que realiza un proceso más elaborado. El software de IA es capaz de generar codecs de audio a partir de texto y voz, analizando como suena una persona y transformando esa información en lo que llaman 'tokens'. A través de aprendizaje automático, VALL-E es capaz de conocer detalles de la voz y replicar su comportamiento fuera de los tres segundos de muestra.
En un principio, el modelo funciona en inglés, debido a que ha utilizado una librería de audio en este idioma, la cuál contiene 60.000 horas de diálogos cedidos por más de 7.000 personas. Quizás una de las grandes limitaciones de este sistema es que se basa en extraer la voz más parecida al audio que se quiere replicar y amoldarla a lo que el sistema ya reconoce en el catálogo de audios. Puedes echar un vistazo a los ejemplos que se utilizan en la página web de proyecto VALL-E, donde encontrarás no sólo la sintetización final, sino los segundos de voz a replicar y las voces del catálogo.
Como curiosidad, este modelo de IA no sólo es capaz de replicar voces y emociones, sino que también puede simular el entorno, como por ejemplo ofrecer los matices de una voz a través de una llamada de teléfono. La conclusión de los creadores del proyecto pone sobre aviso, finalmente, acerca de los peligros de este tipo de herramientas:
Dado que VALL-E puede sintetizar una voz que mantiene la identidad de quien habla, podría tener posibles riesgos en el mal uso del modelo, como falsear una identificación de voz o hacerse pasar por otra persona. Para mitigar estos riesgos, es posible construir un modelo de detección que sea capaz de discernir si un clip de audio ha sido sintetizado por VALL-E. También pondremos los principios de IA de Microsoft en práctica cuando desarrollemos en profundidad el modelo.